買了地端 AI 運算資源之後呢?
By Appar Insight, 2026年11月9日
許多組織的地端 AI 專案從採購開始:GPU Server、企業版 Linux、開源模型、儲存空間與封閉網路陸續完成驗收。模型能在機房裡回答問題之後,主管通常會接著問:哪些人可以使用?AI 讀了哪些資料?答案是否引用最新法規?不同部門會不會看到彼此的內容?系統、模型與套件又由誰持續維護?
這些問題決定 AI 能否進入日常工作。算力與模型提供生成能力,組織還需要員工使用入口、持續更新的知識、符合組織結構的權限,以及能長期營運的平台。這些能力接起來之後,地端 AI 才能穩定支援研究、法規查詢、外部資訊整理、報告製作與知識傳承。
本文整理地端 AI 基礎設施上線後最常被忽略的工作,並提供一個可以在九十天內開始驗證的導入順序。
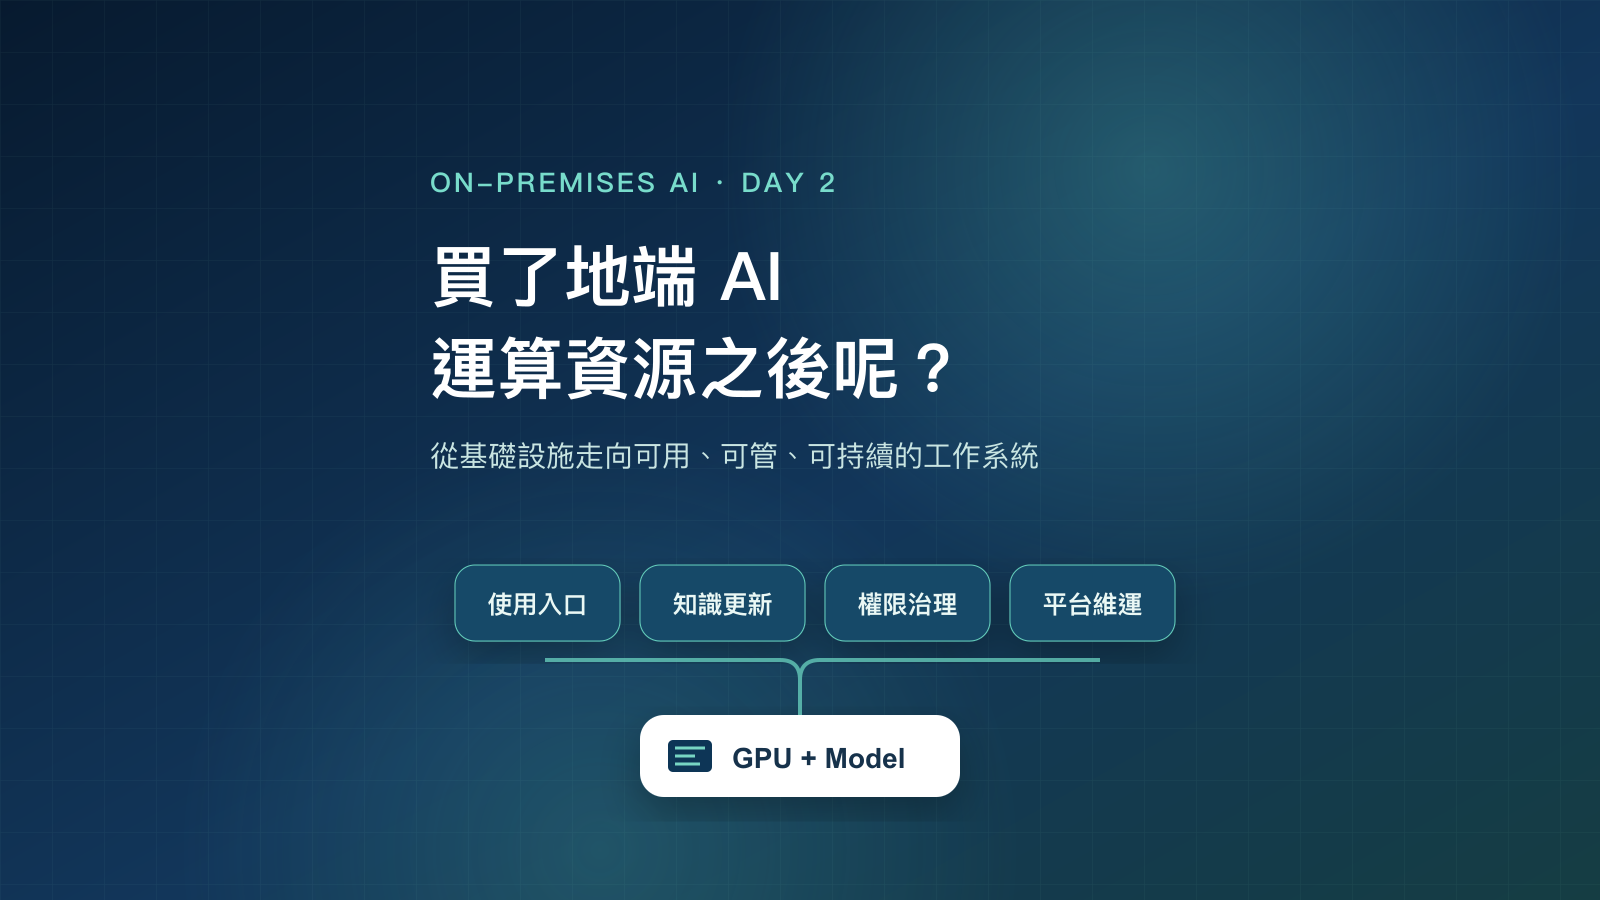
硬體驗收完成後還有四層能力要建立
GPU、作業系統、驅動程式與模型服務回答了「模型能不能跑」。員工真正開始使用時,還需要四層能力共同運作:
- 使用入口:讓員工透過熟悉的介面提問、上傳資料、查看引用與下載成果。
- 知識更新:把內部文件與外部資訊依來源、版本及有效日期持續整理進知識庫。
- 權限治理:依組織、職務、專案與資料等級限制搜尋範圍、模型及可執行工具。
- 平台維運:管理模型版本、GPU 資源、軟體更新、相依套件、監控、備份及資安風險。
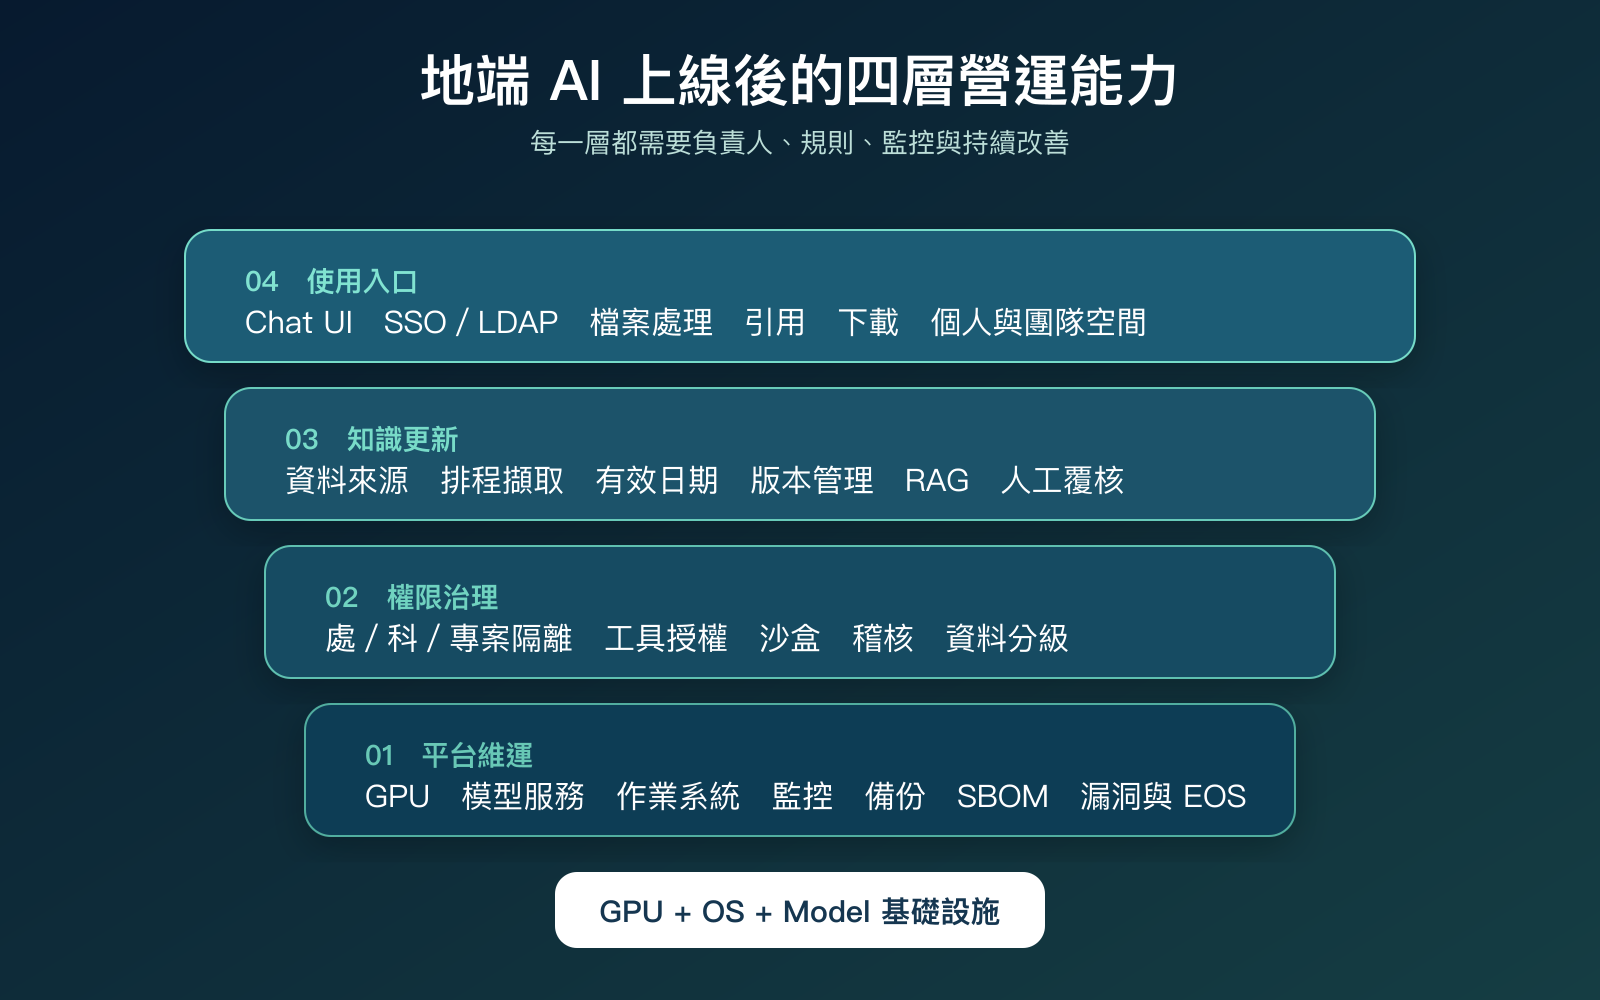
這四層缺少任何一層,都會在使用過程形成瓶頸。介面難用,使用者回到外部工具;知識沒有更新,回答逐漸失去時效;權限只有主機層級,資料容易橫向暴露;維運責任不清,模型、驅動與 Python 套件會在不同專案中累積成難以管理的環境。
AI 的使用介面要能完成工作
類似 ChatGPT 的對話介面是容易理解的起點,但企業所需的使用入口還要承接身分、資料與成果。使用者登入後,系統需要知道他的部門、科別、專案與資料權限;他上傳 PDF、OpenDocument、試算表、錄音或圖片時,也要能看見解析結果、引用來源及處理狀態。
一個可用的企業 AI 入口,至少應回答以下問題:
- 是否能以 LDAP 或 SSO 登入,並在離職、調職時同步停用或調整權限?
- 個人、科內、跨部門與專案知識庫如何區分?
- 回答能否附上文件名稱、頁碼、版本與來源連結?
- 使用者能否下載摘要、比較表、報告草稿或結構化資料?
- 涉及程式執行、檔案轉換或外部 API 時,是否在隔離的沙盒中完成?
- 系統是否保留必要的操作紀錄,同時限制敏感內容進入日誌?
介面的價值可以用完成任務所需的步驟判斷。研究人員若要先把文件搬到另一套工具,再手動貼回引用與摘要,整體流程仍會消耗大量時間。較完整的設計會讓使用者在同一個入口選擇資料範圍、取得有來源的回答、修改內容並交付成果。
地端模型的知識需要有更新與查證流程
模型部署完成後,其內部知識不會自動跟著外部世界更新。金融市場、國際情勢、法規、函釋令與各國機構發布的報告每天都在改變;把新資料放進資料夾,也無法保證 AI 會使用正確版本。
檢索增強生成(RAG)會先從獨立的知識庫找出相關資料,再交給模型形成回答。這讓組織可以更新知識庫,而不必每次重新訓練模型。真正影響可信度的,是知識更新流程是否保存下列資訊:
- 資料來自哪一個官方網站、資料庫或內部文件系統;
- 何時取得、適用期間與目前有效版本;
- 解析與索引是否成功,哪些頁面或欄位無法讀取;
- 新舊版本如何取代,舊資料是否仍需保留供歷史查詢;
- 回答使用了哪些段落,以及使用者能否回到原始資料核對。
例如,研究單位可以每季收集國外主管機關、央行及研究機構的新報告,依國家、主題、發布時間與資料類型建立索引。使用者詢問近期經濟變化時,系統先限定時間與來源,再產生比較摘要;報告中的數字、推論與引用仍由承辦人確認。更新頻率應依資料變化速度決定,利率決策與重大法規可能需要每日或事件觸發,長期研究資料則可按月或按季更新。
NIST 的生成式 AI 風險管理資料把虛構內容、資料隱私與資訊安全列為需要持續管理的風險。降低錯誤回答需要來源限制、版本管理、測試題集、引用檢查與人工覆核共同配合,無法只靠提示詞要求模型「不要產生幻覺」。
資料留在機房仍要控制每一次查詢的範圍
地端部署讓資料與模型留在組織控制的環境,使用者之間的資料邊界仍要另外設計。處、科、專案與個人可能同時存在不同層級的文件;同一位使用者也可能擁有多個角色,並在職務異動後改變可存取範圍。
權限控制應從登入一路延伸到資料檢索與工具執行:
- 身分由 LDAP 或 SSO 統一管理,避免 AI 平台形成另一套長期未清理的帳號;
- 知識庫依部門、專案、資料等級與角色授權,搜尋階段就排除無權查看的內容;
- 外部搜尋、寄信、建立案件、執行程式與呼叫 MCP Server 等動作各自設定權限;
- 沙盒限制程式可使用的檔案、網路、CPU、記憶體、GPU 與執行時間;
- 重要操作留下使用者、資料來源、模型、工具、時間與結果,供稽核與問題追查。
行政院及所屬機關使用生成式 AI 參考指引要求公務使用兼顧機密性、專業性、安全、隱私、資料治理與問責,也強調產出需由業務承辦人進行最終判斷。數位發展部的公部門人工智慧應用參考手冊則把焦點放在以 AI 解決實際業務痛點。兩項原則合在一起,代表地端 AI 專案需要同時設計可用性與控制機制。
AI 平台上線後要有人負責日常營運
正式環境會持續變動。作業系統與驅動需要安全更新,模型會推出新版本,Python 環境與開源套件會出現漏洞或停止維護,知識庫與儲存空間也會成長。若責任停留在採購規格或專案驗收文件,問題發生時很難快速找到決策者。
| 責任 | 需要持續回答的問題 |
|---|---|
| 平台維運 | 誰負責作業系統、驅動、模型服務、備份、監控與故障處理?更新前在哪裡驗證? |
| 資源管理 | 各部門、專案與模型用了多少 GPU、記憶體、儲存空間與推論時間?如何設定配額? |
| 模型治理 | 目前允許哪些模型?版本何時更新?品質、安全性與相容性由誰測試? |
| 資料治理 | 哪些來源可以進入知識庫?誰確認有效日期、權限、保留期限與移除條件? |
| 軟體供應鏈 | 系統包含哪些套件、容器與模型檔案?是否存在已知漏洞、授權問題或停止支援的元件? |
| 業務成效 | 哪些流程縮短了時間?回答修正率、引用完整度與持續使用率如何變化? |
NVIDIA 的 Data Center GPU Manager 可收集 GPU 健康、使用率、程序與工作層級統計,協助管理者理解設備是否閒置、過載或出現異常。這些資料能改善資源配置,但 GPU 使用率本身無法代表業務價值;平台還要把資源用量連回部門、專案、模型與實際工作。
AI 平台通常包含大量開源套件與容器。CISA 的軟體物料清單(SBOM)共同指引指出,軟體元件透明度能縮短漏洞辨識與回應時間,也能提早發現停止維護或停止支援的元件。組織可為每次平台與模型服務版本保存 SBOM,定期比對漏洞、授權及 EOS/EOL 狀態,並把修補責任排入日常維運。
九十天先驗證一條有價值的工作流程
地端 AI 容易同時收到新聞摘要、法規查詢、專案管理、程式開發、文件搜尋與報告生成等需求。全部一起做會讓資料、權限與評估方法迅速膨脹。較有效的起點,是選擇一條高頻、資料來源清楚、人工結果可核對的流程。
例如「整理指定國家或機構近期發布的經濟資料,產生附來源的比較報告」就能涵蓋外部資料更新、文件解析、知識檢索、摘要、引用、權限與成果下載。導入可分成三個階段:
- 第 1 至 30 天:確認使用者、現行流程、資料來源、機密等級、最終成果與負責人;整理二十至五十個真實問題及正確答案,作為測試題集。
- 第 31 至 60 天:完成 SSO、部門權限、知識更新、來源引用與唯讀試用;記錄無法回答、引用錯誤及解析失敗的情況。
- 第 61 至 90 天:比較導入前後的搜尋時間、報告完成時間、引用完整度與人工修正量;確認稽核與維運責任後,再擴大資料來源與使用人數。
評估時應同時看使用、品質、風險與成本。每週活躍使用者能反映入口是否實用;正確引用率與人工修正率能反映回答品質;越權查詢與敏感資料事件能檢查治理;每份成果的推論時間與資源消耗則協助估算成本。這些指標比「部署了幾個模型」更接近主管需要的決策資訊。
地端 AI 的下一步,是把運算能力轉成一套能被員工使用、能持續更新知識、能控制資料邊界,也能由資訊團隊長期維護的工作系統。從一條可核對的流程開始,組織才能逐步累積共用知識、操作方法與治理經驗,讓硬體投資持續產生價值。
約沛科技協助政府機關與企業規劃地端 AI 使用入口、知識庫、權限治理、AI Agent、MCP 整合與系統維運。如果你的組織已經完成 GPU 與模型部署,正在思考下一階段如何讓員工使用,可以聯絡我們一起盤點適合先驗證的工作流程。